· 6 min de lectura
Papiro: leer la web en la Kindle antes de dormir
Diseño de un servicio que convierte links en artículos de diario y los manda a la Kindle, con Go, un agente editor y cero costo.
Este post es el diseño de un proyecto que todavía no existe. Lo escribo antes de escribir la primera línea de código porque obliga a responder las preguntas incómodas temprano: qué modelo, dónde corre, cuánto cuesta, qué puede salir mal.
El problema
En realidad son dos, y uno alimenta al otro.
1. Guardo más links de los que alcanzo a leer. Durante el día me cruzo con posts técnicos, noticias, un instructivo para algo que quiero hacer el fin de semana. Los abro, los dejo en una pestaña o en “leer después”, y ahí se quedan. No es falta de interés: es falta de un momento tranquilo para leerlos.
2. Ese momento tranquilo es la noche, y lo arruino con el celular. Cuando me acuesto, agarro el celular para ponerme al día con todo lo que guardé. Pantalla brillante, notificaciones, un link que lleva a otro. Después de un rato con esa pantalla, me cuesta dormirme.
La Kindle resuelve el segundo problema por cómo está hecha: tinta electrónica, sin notificaciones, sin pestañas. Lo que falta es un puente cómodo entre “este link me interesa” y “está en mi Kindle, listo para leer”.
La idea: Papiro
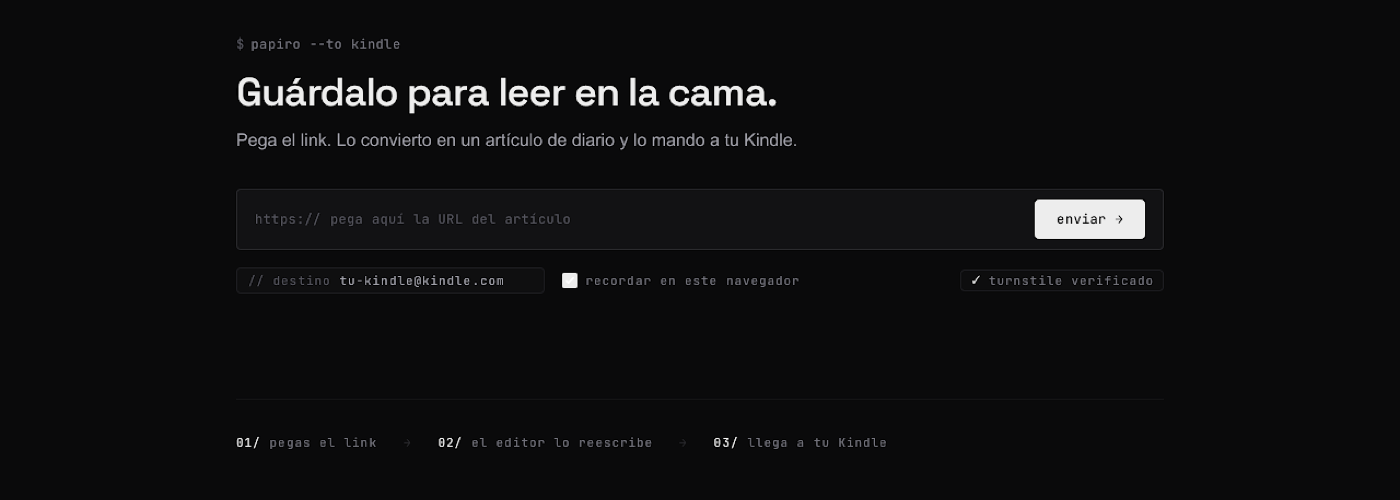
Un servicio en papiro.duv0-x.cloud con una sola caja de texto, como un buscador:
- Pego la URL del artículo.
- Un agente editor lee el contenido y lo reescribe como un artículo de diario: limpio, en español, con titular, bajada, tiempo de lectura y la fuente original.
- El servicio arma un EPUB con estética de periódico y lo manda por correo a mi Kindle.
En la noche, en vez del celular, agarro la Kindle y ahí está la “edición nocturna” con lo que guardé durante el día.
Mientras el agente trabaja, la página muestra una barra de progreso con algo de humor: una rotativa en ASCII que imprime la primera plana y avanza con las etapas reales del proceso.
Arquitectura
navegador ──▶ Cloudflare (DNS · Turnstile) ──▶ Cloud Run: servidor Go
                                                 │
                         1. descarga la URL      │  (protección SSRF)
                         2. extrae el contenido  │  go-readability
                         3. agente editor        │  Ollama Cloud → JSON
                         4. arma el EPUB         │  html/template + go-epub
                         5. envía a la Kindle    │  Resend (@papiro.duv0-x.cloud)
                                                 ▼
                                      tu-kindle@kindle.com
Todo el trabajo ocurre dentro de una sola petición. El navegador la abre con Server-Sent Events y el servidor va emitiendo cada etapa a medida que termina. Así la barra de progreso muestra avances reales, sin cola de trabajos, sin base de datos y sin polling.
Las decisiones
EPUB, no PDF
La primera intuición fue un PDF con diseño de periódico. Pero un PDF es una foto fija: en una pantalla de 6" no se puede agrandar la letra, subrayar es torpe y las columnas obligan a hacer zoom. Un EPUB se convierte al formato nativo de la Kindle cuando entra por Send to Kindle. El texto fluye, puedo elegir tipografía y tamaño, subrayar y buscar palabras en el diccionario.
La estética de diario se logra con CSS dentro del EPUB: cabecera con el nombre de la “publicación”, filetes, serif, capitulares, bajada en cursiva. La Kindle no respeta todo el CSS, así que el diseño tiene que verse bien aunque se pierdan algunas reglas.
Extraer antes de pensar
No le paso el HTML crudo al modelo. Primero, un port de Readability en Go (go-readability) saca el contenido principal: sin menús, banners de cookies, comentarios ni “artículos relacionados”. El agente recibe texto limpio, lo que significa menos tokens, menos ruido y menos alucinación. La parte determinista la hace el código y la de criterio, el modelo.
JSON, no TOON
Pensé en usar TOON como formato intermedio. TOON ahorra tokens cuando la entrada es tabular: muchos objetos con los mismos campos. Un artículo no es eso: es prosa. Para la salida del agente importa más que la estructura sea confiable, y ahí gana JSON con un schema. Ollama permite exigir un JSON Schema en la respuesta, así que el modelo devuelve exactamente esto:
type Article struct {
	Title       string    `json:"title"`
	Dek         string    `json:"dek"`          // bajada
	Byline      string    `json:"byline"`
	SourceURL   string    `json:"source_url"`
	ReadingMins int       `json:"reading_mins"`
	Sections    []Section `json:"sections"`
}

type Section struct {
	Heading    string   `json:"heading,omitempty"`
	Paragraphs []string `json:"paragraphs"`
	PullQuote  string   `json:"pull_quote,omitempty"`
}
Ese struct es el contrato entre el agente y el resto del sistema. El EPUB se renderiza con html/template a partir de él, y el modelo nunca escribe HTML.
El editor: un modelo de Ollama Cloud
Ya pago Ollama Cloud, así que el agente editor corre ahí, sin costo adicional. La instrucción es de edición fiel: conservar las ideas, la estructura y los datos del original, quitar el relleno, traducir al español si hace falta y nunca inventar. Antes de elegir el modelo, voy a comparar varios con un conjunto fijo de artículos de distintos idiomas y largos. Lo que sí sé es que hay que evitar los modelos que gastan el presupuesto de tokens “pensando” y devuelven una respuesta vacía.
Go en Cloud Run, Cloudflare al frente
El backend es Go con Gin, Templ y HTMX: el HTML se renderiza en el servidor, igual que en proyectos anteriores. Quería que todo viviera en Cloudflare, pero los números no dan:
| Opción | Problema |
|---|---|
| Workers (plan gratis) con Go en Wasm | 10 ms de CPU por petición y scripts de máximo 3 MB. Parsear HTML y armar un EPUB no cabe en esos límites. |
| Cloudflare Containers | Corre el binario de Go tal cual, pero requiere el plan Workers Paid (USD 5/mes). |
| Cloud Run | El plan gratuito sobra para uso personal, escala a cero y acepta peticiones de varios minutos. |
Cloudflare se queda con lo que mejor hace: DNS, el subdominio y Turnstile.
El correo: Resend
Cloudflare tiene envío de correo, pero en el plan gratuito solo llega a direcciones verificadas, y una dirección @kindle.com no puede hacer clic en un link de verificación. Resend tiene un plan gratuito más que suficiente y verifica el subdominio papiro.duv0-x.cloud con registros DNS en Cloudflare. Los EPUB salen desde kindle@papiro.duv0-x.cloud, que hay que agregar una vez a la lista de correos aprobados en la cuenta de Amazon.
Seguridad: un formulario que manda correos
Un servicio público que recibe una URL y envía un correo tiene dos riesgos obvios:
- Spam. Solo se envía a direcciones
@kindle.comque estén en una lista blanca. El formulario está protegido con Turnstile, el sistema antibots de Cloudflare, que casi siempre se resuelve sin que el usuario haga nada, y hay un límite de envíos por día. - SSRF. El servidor descarga URLs arbitrarias. Hay que bloquear IPs privadas y de metadatos (
169.254.169.254,10.0.0.0/8,localhost…), resolver el DNS y validar la IP antes de conectar, y limitar el tamaño y el tiempo de la descarga.
Costo
| Pieza | Servicio | Costo |
|---|---|---|
| Dominio, DNS, antibots | Cloudflare | USD 0 |
| Backend Go | Cloud Run (plan gratuito) | USD 0 |
| Agente editor | Ollama Cloud (suscripción existente) | USD 0 adicional |
| Correo | Resend (plan gratuito) | USD 0 |
Lo que sigue
- Comparar modelos de Ollama Cloud para elegir el editor.
- Diseñar el CSS del EPUB y probarlo en una Kindle real, porque el emulador miente.
- Decidir qué hacer con las imágenes del artículo original: incluir solo la principal, todas, o ninguna.
- Manejar los paywalls: si el contenido no se puede extraer, el servicio debe decirlo en vez de inventar.
Cuando esté construido, el siguiente post contará cómo salió, incluido en qué se equivocó este diseño.